무엇을 하나
xerj-org/xerj는 xerj autoindex <폴더> 명령 하나로 지정한 폴더를 자동 색인하는 로컬 AI 검색 엔진이다. 코드, 문서, 로그, PDF, SQLite, CSV 등을 파일 형식에 맞춰 분석해 데이터셋별 인덱스를 만든다. 스키마나 파이프라인을 따로 설정할 필요가 없다고 README는 설명한다.
핵심 용도는 '참조 코딩'이다. 에이전트가 작업과 비슷한 오픈소스 저장소를 내려받아 색인한 뒤, 코드를 쓰기 전에 해당 구현 방식을 검색해 참고하게 하는 방식이다. 이 밖에 코드베이스 질의응답(RAG), 보안 감사, 로그 분석, 에이전트 장기 기억(/_memory/{namespace})에도 쓸 수 있다.
작동 방식
파일 형식을 자동 판별해 데이터셋 단위로 인덱스를 만든다. 소스 코드는 트리시터(tree-sitter)로 분석해 심볼과 줄 번호를 함께 저장하므로, 에이전트는 파일 전체 대신 file:line 형태의 관련 구절만 받는다. 개발 환경 예시 로그에는 25,329개 파일을 158초에 처리해 593개 데이터셋, 8만여 건의 레코드를 만든 결과가 실려 있다.
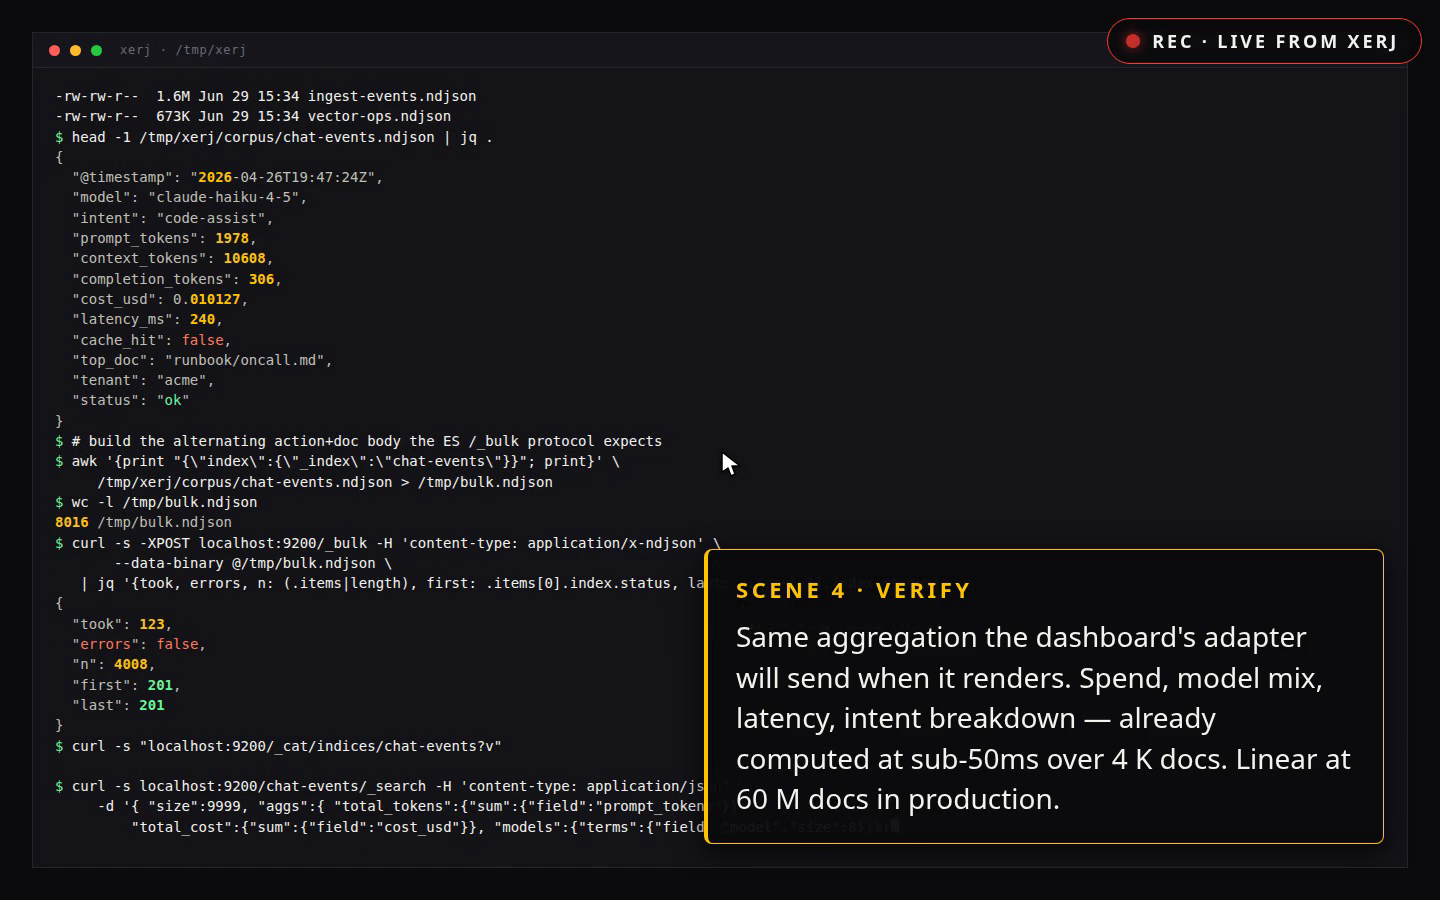
검색은 엘라스틱서치 문법(전문 검색, 집계, knn·semantic 벡터·하이브리드 검색)을 그대로 쓰며, 기존 클라이언트 라이브러리를 localhost:9200에 연결하면 된다. 단일 정적 바이너리로 JVM이 필요 없고 리눅스·macOS·윈도우의 x86-64, arm64용이 제공된다. MCP 서버로도 동작한다.
써보면
curl -fsSL https://xerj.org/get | sh
xerj --insecure --data-dir ./data &
xerj init
xerj autoindex ~/my-project
xerj search "how do we rotate the WAL segment"
xerj init은 Claude Code나 Cursor에 MCP와 스킬을 연결한다. --insecure는 TLS와 인증을 끄는 옵션으로, 로컬 개발 머신에서 한 사용자가 쓰는 경우만 상정한다. 기본은 127.0.0.1에만 바인딩되며, 공유 환경에서는 인증을 켠 상태로 API 키를 지정해야 한다.
의의와 한계
README는 8개 과제, 4개 언어, 방식당 16회 실행한 통제 실험에서 grep 기반 에이전트의 출력 토큰이 26,477개였던 반면 XERJ는 9,982개로 약 2.7배 적었고, 해결률은 둘 다 16/16이었다고 밝혔다. 비용은 3.27달러 대 1.58달러다. 사용자 보고로는 실무에서 약 5배 절감이라고 한다. 다만 모두 프로젝트 측 수치이며 독립 검증은 확인되지 않았다.
프로젝트 스스로도 이 효과는 모델이 외우지 못한 비공개·사내·틈새·최신 코드에서 크고, 모델이 이미 아는 인기 공개 라이브러리에서는 효과가 없거나 오히려 해로울 수 있다고 한계를 인정한다. 라이선스는 Apache-2.0이다. 외부 재순위 서비스 Jev를 켜면 검색 결과 텍스트가 외부 서버로 전송되므로 주의가 필요하다. 사용 대가로 짧은 사용 후기(field report) PR을 요청하는 점도 특징이다.