| 한눈에 보기 | |
|---|---|
| 저장소 | higgsfield-ai/higgsfield |
| 개발 | higgsfield-ai (조직) |
| GitHub 스타 | 6,158 (오늘 +13) |
| GitHub 트렌딩 | 일간 Jupyter 15위 |
| 포크 | 1,125 |
| 주 언어 | Jupyter Notebook |
| 라이선스 | Apache-2.0 |
| 공개일 | 2018-05-26 |
| 최신 릴리스 | v0.0.4-rc (2024-03-23) |
힉스필드(Higgsfield) 팀이 공개한 오픈소스 프로젝트 higgsfield-ai/higgsfield가 GitHub 트렌딩에 올랐다. 멀티노드 GPU 학습의 번거로움을 줄이겠다는 'GPU 오케스트레이션 겸 머신러닝 프레임워크'다. 일간 Jupyter 부문 15위에 오르며 관심을 끌고 있다. 프로젝트는 README 첫 줄에서 "울지 않고 하는 멀티노드 학습"을 내세운다.
무엇을 하나: GPU 워크로드 관리와 분산 학습
README는 이 도구의 역할을 다섯 가지로 정리한다.
- 사용자별로 학습용 컴퓨팅 노드를 독점 또는 공유 방식으로 할당
- 마이크로소프트 딥스피드(DeepSpeed)의 ZeRO-3 API와 파이토치(PyTorch)의 FSDP(완전 분할 데이터 병렬) 지원
- 할당된 노드에서 대형 신경망 학습을 시작·실행·모니터링하는 프레임워크 제공
- 실험 대기열을 두어 자원 경합 관리
- GitHub 및 GitHub Actions와 연동한 ML 개발의 지속적 통합(CI)
프로젝트는 ZeRO-3와 FSDP로 조 단위 파라미터 모델의 효율적 분할이 가능하다고 설명한다. 다만 구체적인 성능 수치나 벤치마크는 제시하지 않았다.
작동 방식: 서버 설치부터 GitHub 배포까지
흐름은 네 단계다. 먼저 사용자의 서버에 도커(Docker), 프로젝트 배포 키, 힉스필드 바이너리를 설치한다. 이어 실험별 배포·실행 워크플로를 자동 생성한다. 코드가 GitHub에 올라가면 각 노드에 자동 배포되고, 사용자는 GitHub의 실행 화면에서 실험을 띄우고 체크포인트를 저장한다.
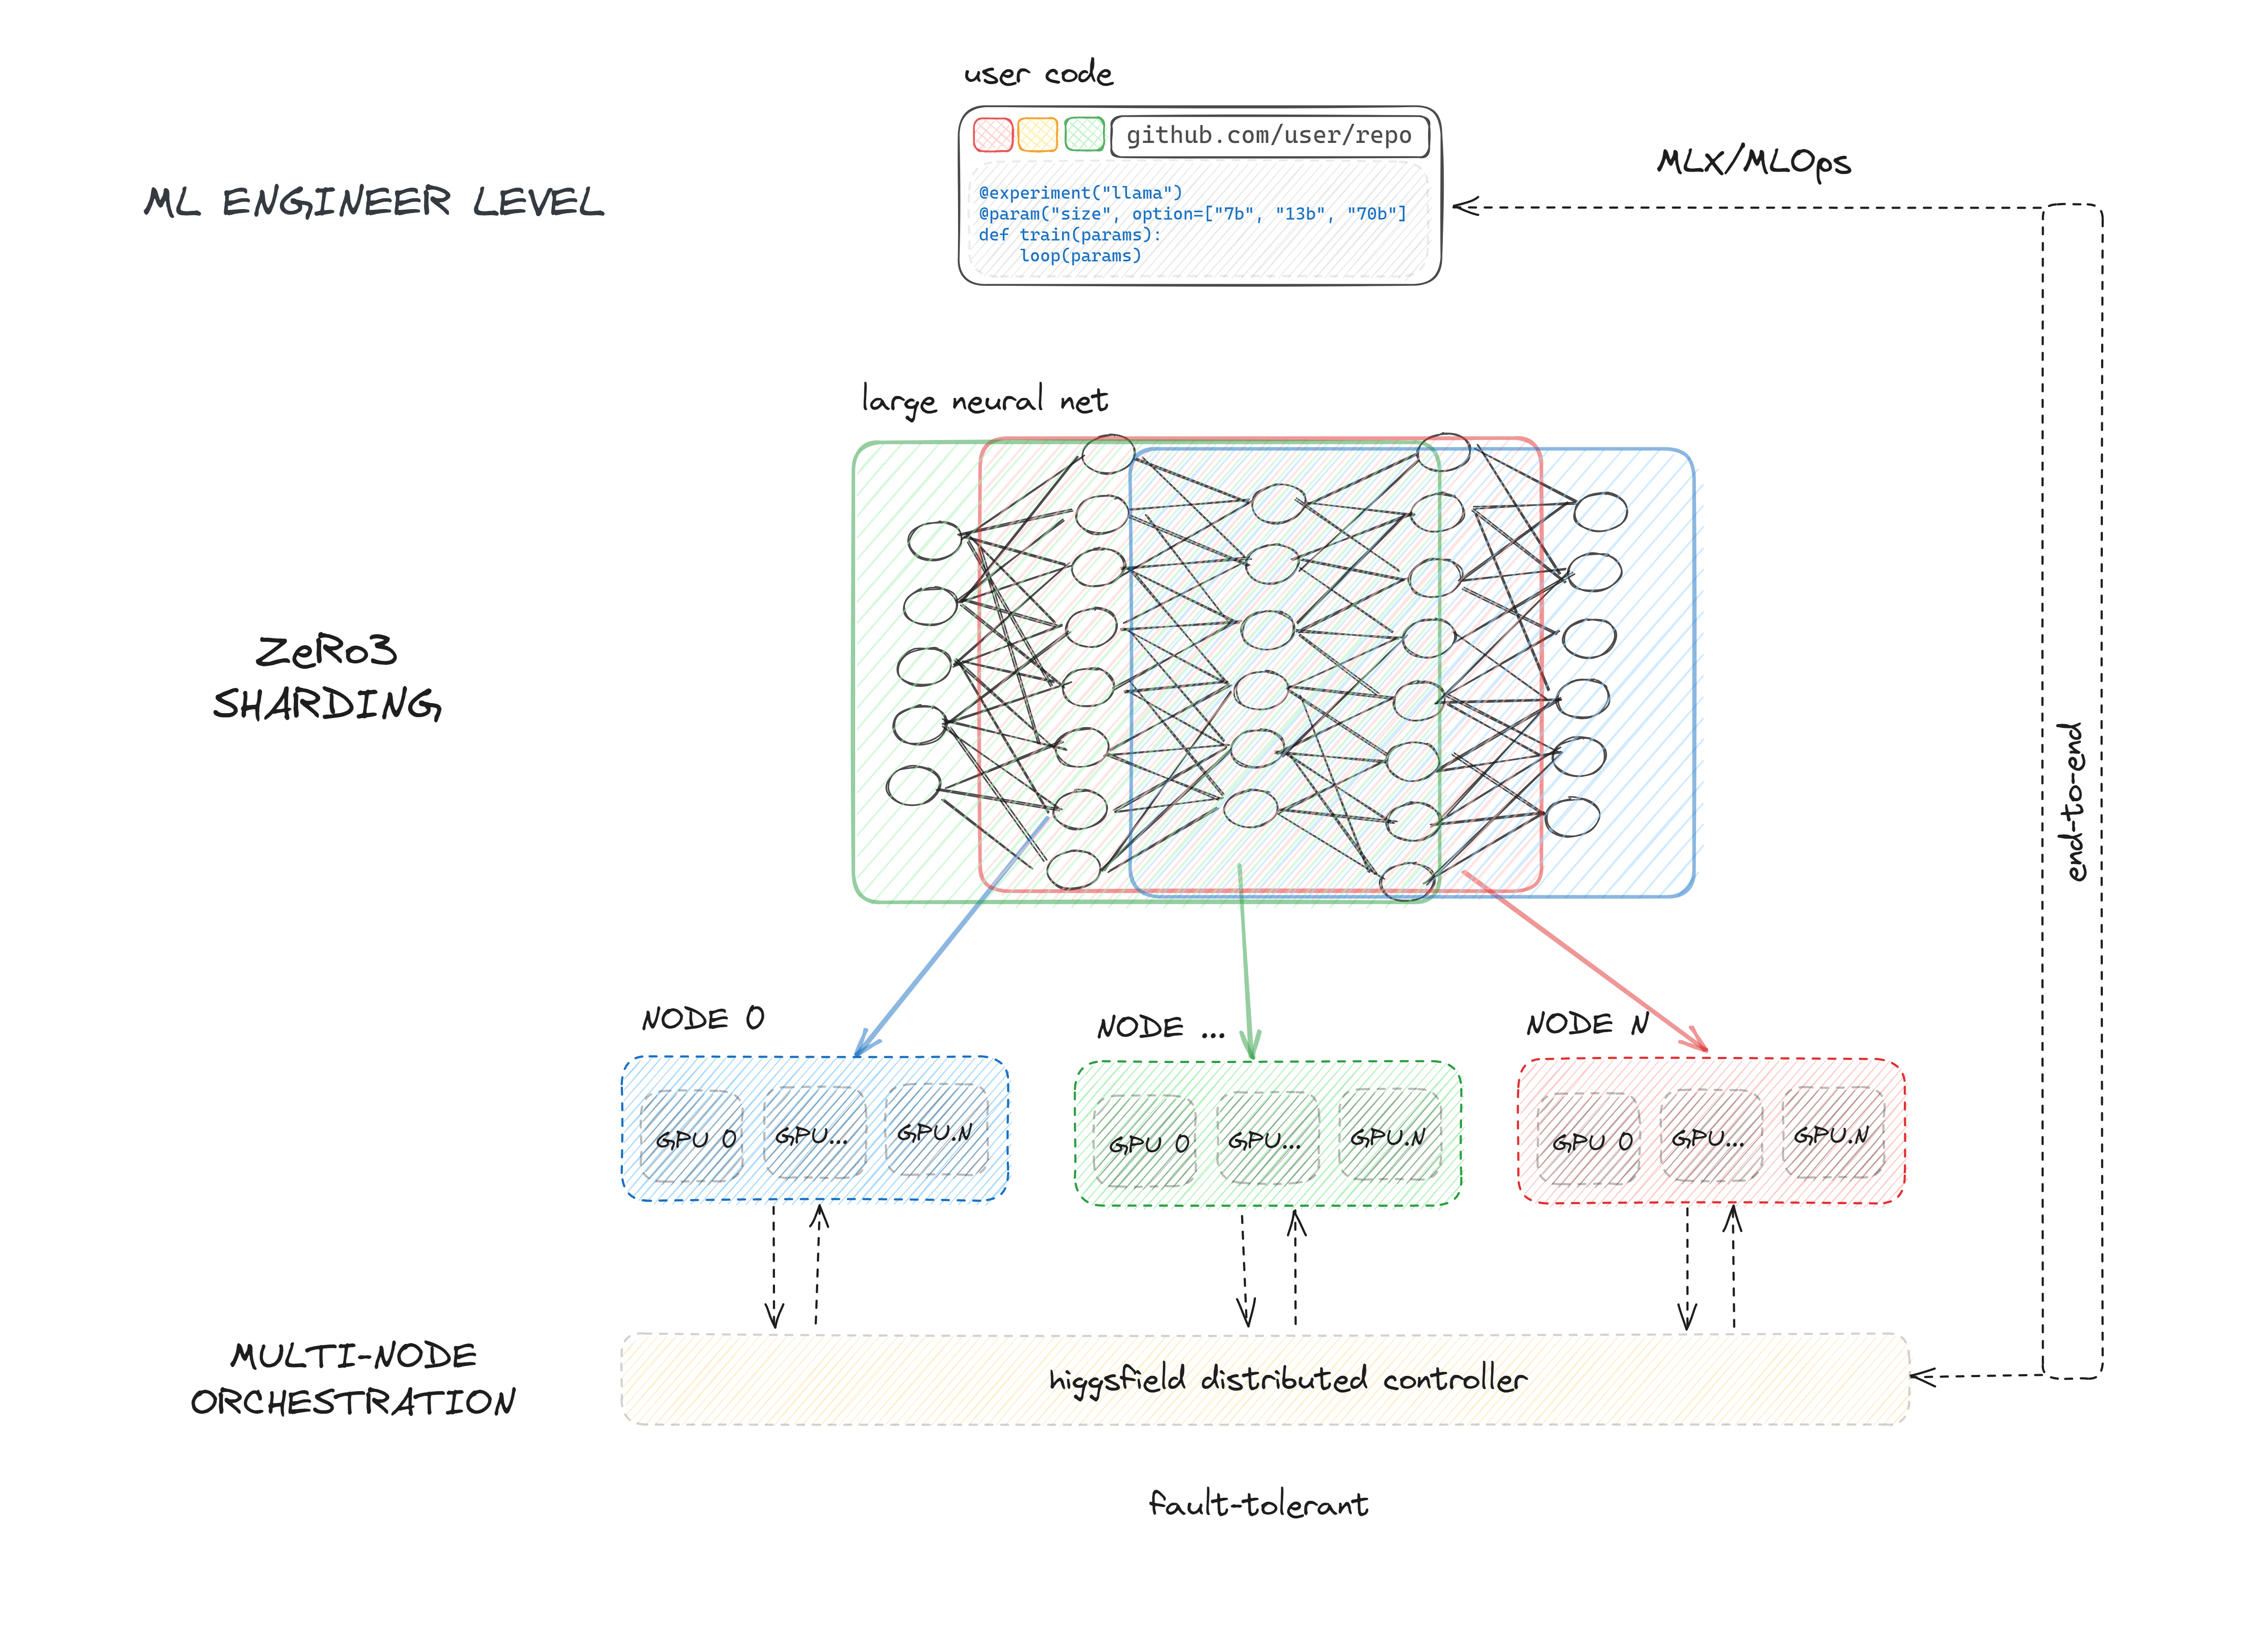
설계는 표준 파이토치 작업 방식을 따른다. 그래서 deepspeed나 accelerate를 함께 쓰거나 직접 만든 샤딩 로직을 넣을 수도 있다. README는 "환경 지옥"(파이토치·드라이버 버전 충돌)과 "설정 지옥"(수백 개 인자, YAML 설정)을 줄이는 것이 목표라고 밝혔다. 실험 환경과 의존성 버전을 기록해 재현성을 확보한다는 설명도 있다.
써보면: 데코레이터 하나로 라마 70B 학습
설치는 pip으로 한다. README는 다음 버전을 안내한다.
pip install higgsfield==0.0.3
실험은 @experiment 데코레이터로 정의한다. README의 라마(Llama) 70B 예시는 아래와 같다.
@experiment("alpaca")
def train(params):
    model = Llama70b(zero_stage=3, fast_attn=False, precision="bf16")
    optimizer = optim.AdamW(model.parameters(), lr=1e-5)
    train_loader = LlamaLoader(dataset, max_words=2048)
    for batch in train_loader:
        optimizer.zero_grad()
        loss = model(batch)
        loss.backward()
        optimizer.step()
    model.push_to_hub('alpaca-70b')
모델 생성 시 ZeRO 단계와 정밀도를 지정하고, 나머지는 일반적인 파이토치 학습 루프와 같다.
최근 업데이트: v0.0.4-rc
최신 릴리스는 2024년 3월 공개된 v0.0.4-rc다. 릴리스 노트에 따르면 주요 변경은 다음과 같다.
- 액션 빌더의 기본 필드 생성 수정
- 필요 시 인보커(invoker) 버전을 지정하는 기능 추가
- 파이썬이 없는 마스터 호스트에서도 인보커를 실행하도록 개선
- SSH 라이브러리 asyncssh를 2.14.1로 상향
누구에게 유용한가
자체 GPU 서버나 GPU 클라우드를 빌려 라마 계열 모델을 미세조정하려는 소규모 ML 팀에 맞는다. GitHub 중심으로 일하는 팀이라면 코드 푸시 후 실행 화면에서 실험을 돌리는 방식이 익숙할 것이다. 여러 사용자가 노드를 나눠 쓰는 연구실에서도 할당·대기열 기능이 쓸모 있을 수 있다.
의의와 한계
라이선스는 아파치 2.0(Apache-2.0)이라 상업적 활용이 자유롭다. 다만 성숙도는 따져봐야 한다. 최신 릴리스가 1.0 이전의 릴리스 후보(rc)이고 마지막 릴리스 이후 시간이 꽤 흘렀다. README의 설치 안내 버전(0.0.3)도 릴리스보다 낮다. 최근 커밋은 2026년 10월이라 개발이 완전히 멈춘 것은 아니다.
요구 조건도 있다. 노드는 우분투(Ubuntu)에 SSH 접속이 가능해야 하고, 비밀번호 없이 sudo를 쓸 수 있는 일반 사용자 계정이 필요하다. 테스트된 클라우드는 애저(Azure), 람다랩스(LambdaLabs), 플루이드스택(FluidStack)이다. 쿠버네티스나 슬럼(Slurm) 같은 기존 클러스터 관리 도구와의 비교는 README에 없어 직접 검증이 필요하다.